你的订单表从 100 万行涨到了 5000 万行。
•B+ 树树高从 3 层变成 5 层,磁盘 I/O 次数增加
你加了读写分离,扛了一阵。但表还是越来越大,慢查询还是越来越多。
单表已经到极限了,怎么办?分库分表。
白话版
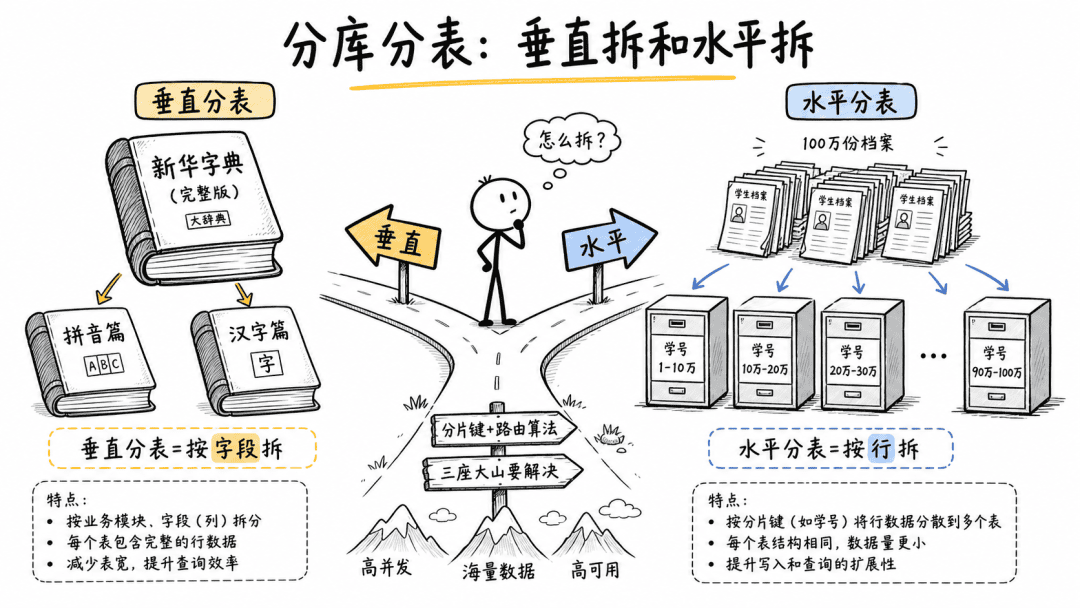
分库分表有两种思路:
垂直切分(按字段拆) — 像把一本厚字典拆成《拼音篇》和《汉字篇》:
一本综合词典(所有字段放一起)
  ├── 拆出《拼音篇》→ 存拼音、读音(高频字段)
  └── 拆出《汉字篇》→ 存释义、例句(低频大字段)
相当于:把一张宽表(字段多)拆成多张窄表(字段少)
水平切分(按行拆) — 像把 100 万个学生的档案按学号分散到 10 个档案柜:
100 万份档案(一张表)
  ├── 档案柜 1:学号 1 ~ 100000
  ├── 档案柜 2:学号 100001 ~ 200000
  ├── ...
  └── 档案柜 10:学号 900001 ~ 1000000
相当于:把一张大表(行多)拆成多张结构相同的小表
垂直分表( Vertical Sharding )
把一张宽的订单表,按字段的访问频率拆成多张表:
orders (原表,字段多)
  order_id, user_id, amount, status,
  shipping_address, receiver_info, remark, created_at, ...
垂直拆分后:
  orders_basic(高频字段)
    order_id, user_id, amount, status, created_at
  orders_detail(低频/大字段)
    order_id, shipping_address, receiver_info, remark
优点: 高频字段的表变窄,每行更小,一个磁盘页能放更多行,查询更快。
缺点: 拆开后要 JOIN 才能查完整数据。
分库(按业务域拆)
把不同业务的数据放到不同的数据库:
原库:toy_db
  ├── user 表
  ├── order 表
  ├── product 表
  └── inventory 表
分库后:
  user_db(用户库)
    user 表
  order_db(订单库)
    order 表
  product_db(商品库)
    product 表, inventory 表
好处: 不同业务的磁盘 I/O 、 CPU 、连接池完全隔离,互不影响。
水平分表( Horizontal Sharding )—— 核心
水平分表是解决"单表数据量过大"的主要手段。核心是选好分片键( Sharding Key ) 和路由算法。
分片键选择
分片键是分表的依据,选择标准:
| 标准 | 说明 |
|---|
| 区分度高 | 字段值分布均匀,避免数据倾斜 |
| 查询频率高 | 大多数查询都带这个字段 |
| 不可变 | 该字段值不会修改(改了路由就乱了) |
订单表通常选 user_id 或 order_id 作为分片键。
路由算法
-- 水平分表:按 user_id 取模,拆成 4 张表
SELECT * FROM orders_0 WHERE user_id = ?;  -- user_id % 4 = 0
SELECT * FROM orders_1 WHERE user_id = ?;  -- user_id % 4 = 1
SELECT * FROM orders_2 WHERE user_id = ?;  -- user_id % 4 = 2
SELECT * FROM orders_3 WHERE user_id = ?;  -- user_id % 4 = 3
// 分表路由算法:根据分片键计算目标表
public String routeTable(String shardingKey, int tableCount) {
    // 常用:取模(hash % N)
    int hash = shardingKey.hashCode();
    int tableIndex = Math.abs(hash) % tableCount;
    return "orders_" + tableIndex;
}
// 示例:user_id = 1024,tableCount = 4
// routeTable("1024", 4) → "orders_0"(1024 % 4 = 0)
三种常见路由算法
| 算法 | 计算方式 | 优点 | 缺点 |
|---|
| 取模 | value % N | 简单均匀 | 扩缩容要重算数据 |
| 范围 | 按 ID 区间分 | 扩容简单 | 数据可能倾斜(新数据都在一个表) |
| 一致性哈希 | 哈希环 | 扩缩容影响最小 | 实现复杂 |
分库分表的三座大山
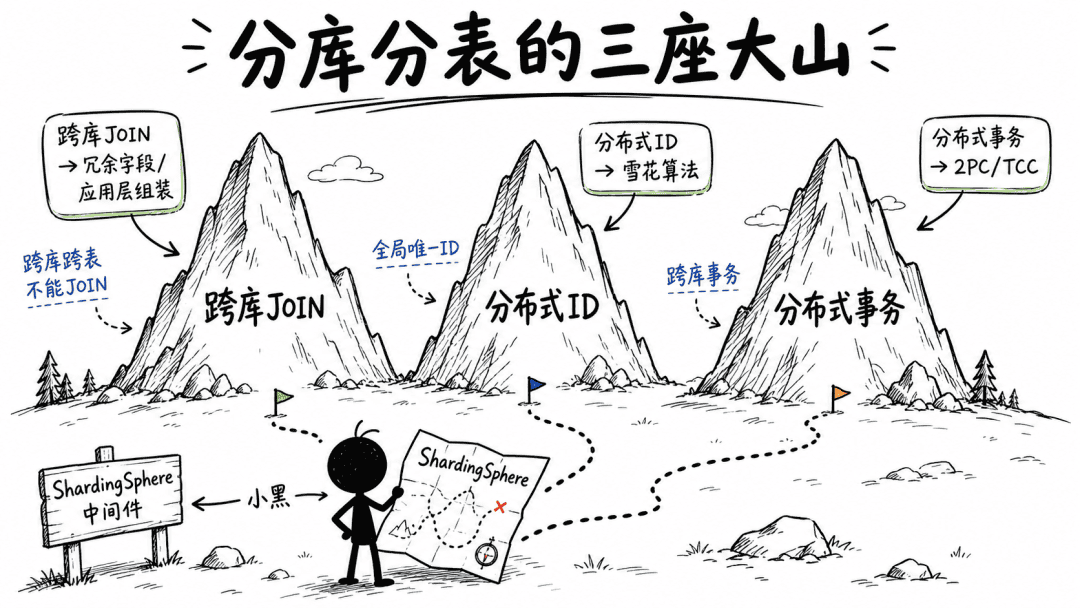
问题一:跨库跨表 JOIN
分表后,orders 和 order_items 可能分到了不同的表,无法直接 JOIN 。
❌ 不行的写法:
SELECT o.*, i.* FROM orders_0 o JOIN order_items_3 i ON o.id = i.order_id
(两个表在不同节点,无法直接 JOIN)
解决方案:
方案 1 :冗余字段(推荐) — 把要关联的字段冗余到主表
-- 订单表冗余了 user_name,查询时不需要 JOIN user 表
SELECT order_id, user_name, amount FROM orders_0 WHERE user_id = 1024;
方案 2 :应用层组装 — 先查主表,再用结果去查关联表
// 先查订单
List<Order> orders = orderDAO.getByUserId(userId);
// 再根据订单查明细(应用层组装)
List<Long> orderIds = orders.stream().map(Order::getId).toList();
List<OrderItem> items = orderItemDAO.getByOrderIds(orderIds);
// 组装返回
方案 3 :宽表(反规范化) — 把明细数据直接合并到主表
问题二:分布式 ID
分表后,自增 ID 会撞车(每个分表的 ID 都是从 1 开始)。
user_id = 1024 → orders_0 → ID = 1
user_id = 1025 → orders_1 → ID = 1
两个订单的 ID 都是 1,但分属不同表。
解决方案: 使用全局唯一 ID 生成器(雪花算法 Snowflake ),详见第五周的文章。
问题三:分布式事务
一个订单的创建,可能跨了订单库、库存库、用户库。单库事务失效,需要分布式事务( 2PC/TCC/最终一致性),详见第五周。
分库分表方案落地
方案一: ShardingSphere (中间件)
rules:
  sharding:
    tables:
      t_order:
        actualDataNodes: db_${0..1}.t_order_${0..3}
        databaseStrategy:
          standard:
            shardingColumn: user_id
            shardingAlgorithmName: db_inline
        tableStrategy:
          standard:
            shardingColumn: order_id
            shardingAlgorithmName: tbl_inline
shardingAlgorithms:
  db_inline:
    type: INLINE
    props:
      algorithm-expression: db_${user_id % 2}
  tbl_inline:
    type: INLINE
    props:
      algorithm-expression: t_order_${order_id % 4}
// 业务代码完全无感,像查单表一样
@Mapper
public interface OrderMapper {
    // ShardingSphere 自动路由到正确的分片
    @Select("SELECT * FROM t_order WHERE order_id = #{orderId}")
    Order getByOrderId(Long orderId);
}
方案二: MyCat / 中介
应用 → MyCat(分库分表代理) → 后端多个数据库节点
应用只连 MyCat,MyCat 负责按照规则把 SQL 路由到正确的分片。
分库分表的时机
| 阶段 | 数据量 | 方案 |
|---|
| 初期 | 1000 万以内 | 单库单表 + 索引优化 |
| 增长期 | 1000 万 - 5000 万 | 读写分离 + 垂直分表 |
| 瓶颈期 | 5000 万以上 | 水平分库分表 |
| 高峰期 | 亿级以上 | 分片 + 归档 + 冷热分离 |
分库分表是最后的手段,不是第一选择。 先做好索引、读写分离、归档,实在扛不住了再分。
小结
分库分表是解决单表数据量过大的终极手段:
•分片键 + 路由算法 — 决定数据怎么分布、查询怎么路由•三座大山 — 跨库 JOIN 、分布式 ID 、分布式事务需要配套解决
一句话总结:分库分表不是"一张表拆成几张表"这么简单,而是一整套架构升级——要同时解决路由、 ID 、事务、查询的问题。 能不分就不分,能晚分就晚分,但一旦需要,就得系统性地解决。
阅读原文:原文链接
该文章在 2026/10/21 10:31:00 编辑过


 400 186 1886