Codex 在别人手里是神器,在你手里像智障:九条实操心法
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
同一套工具落到不同人手上,产出能差出十万八千里。就说 Codex,自媒体吹得像神,可真上手用,我的体感没那么夸张。 不过话说回来,它确实是当下最能打的 Agent 之一,写代码、出图这些日常活都能接。
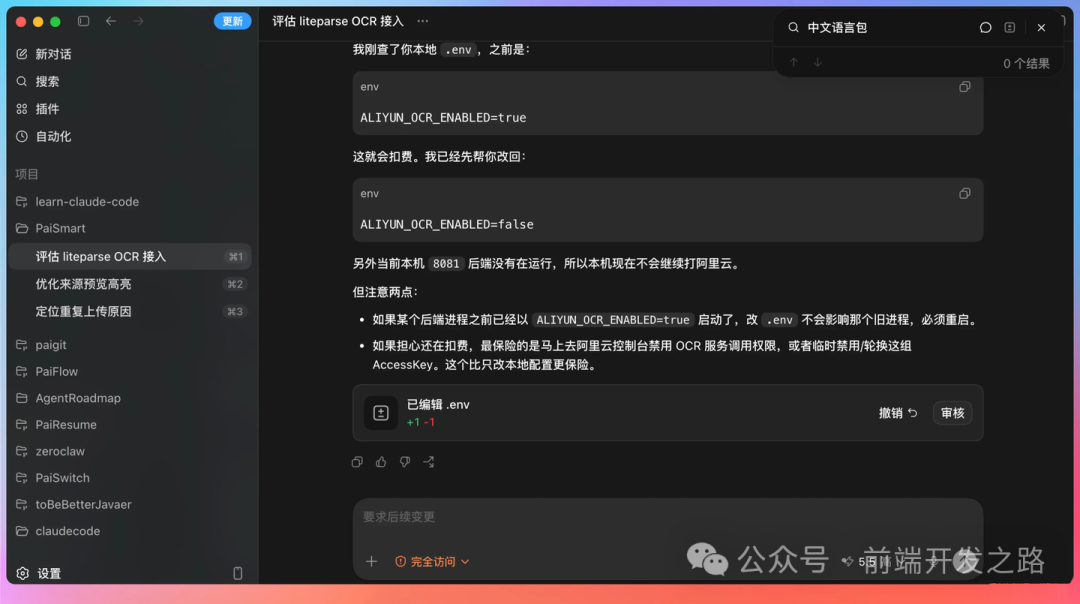
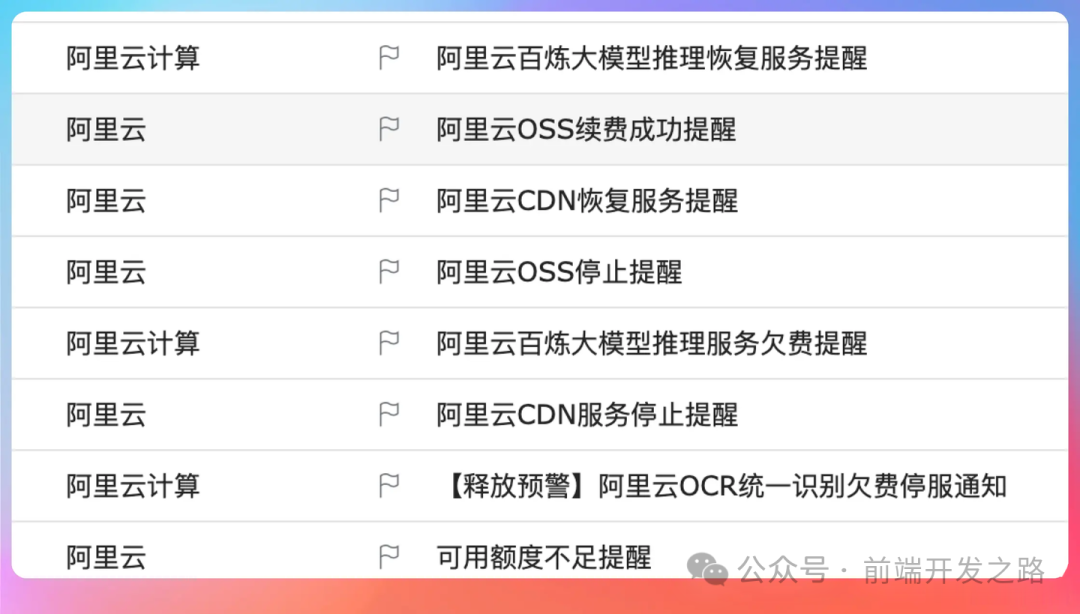
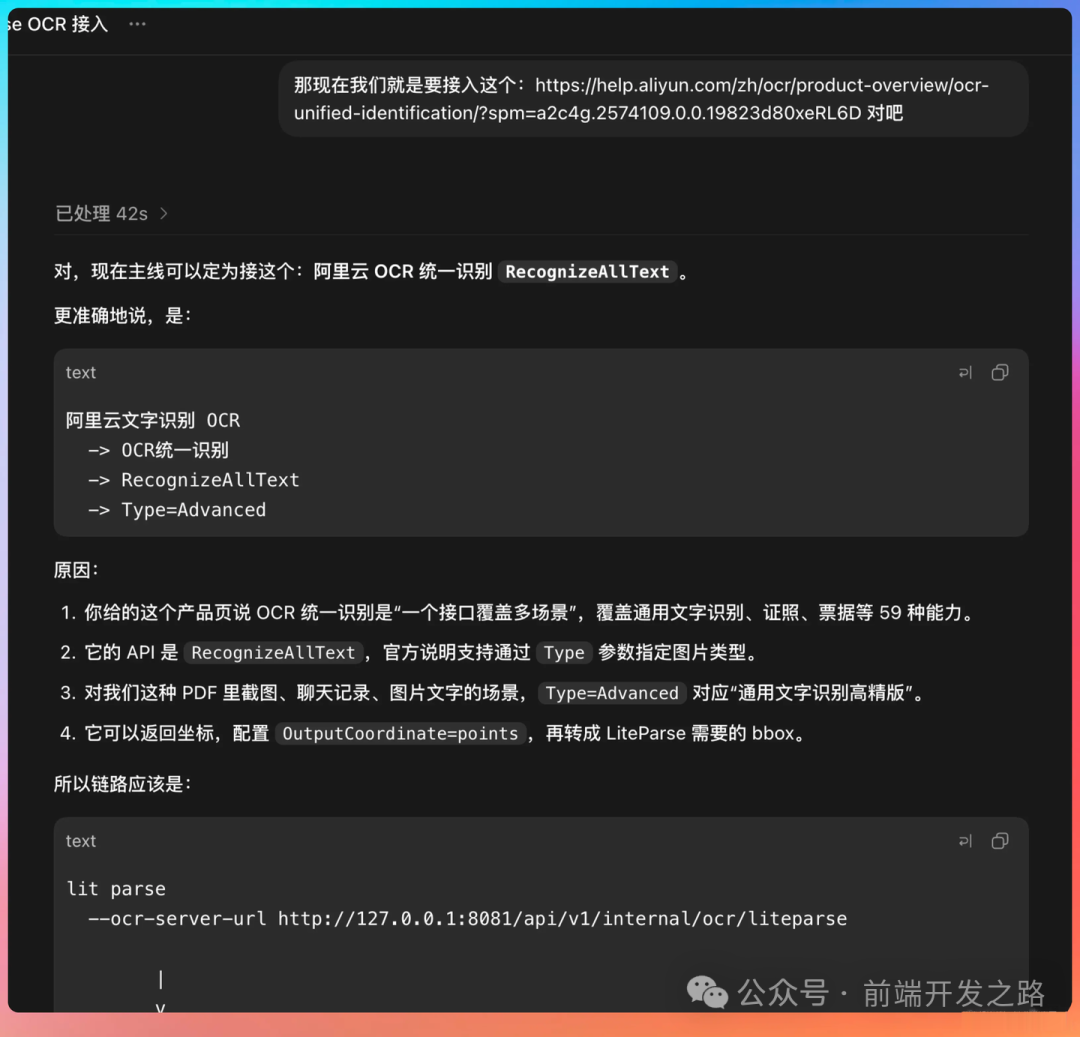
有件事得先摆清楚:主导权现在还在人手里,也就是在你手里。 昨天我让 Codex 在自己的项目里接阿里云 OCR,一天时间账单扣掉七百多块。 麻烦之处在于,这服务开了之后没有开关能关,只能靠代码自己拦。幸亏 .env 里早留了一道全局闸
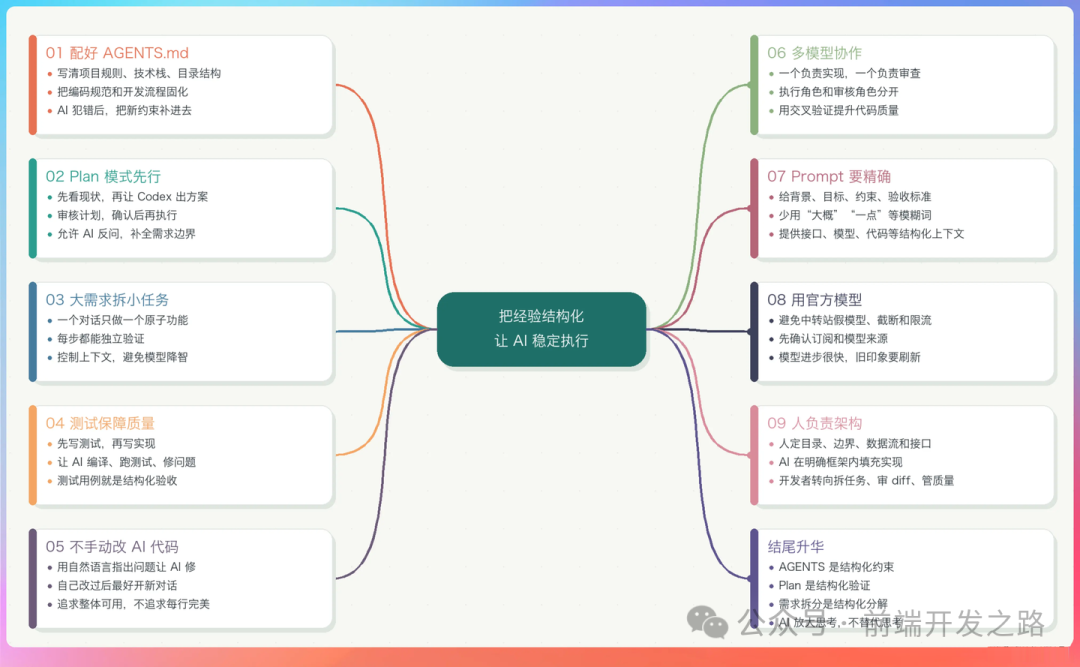
说白了,让 AI 帮忙写代码这件事,得跟它养出默契,不然翻车起来很疼。 下面这些是我自己摔出来的 Codex 用法,一共九条,坐稳了往下看。
一、别一开口就让它写代码
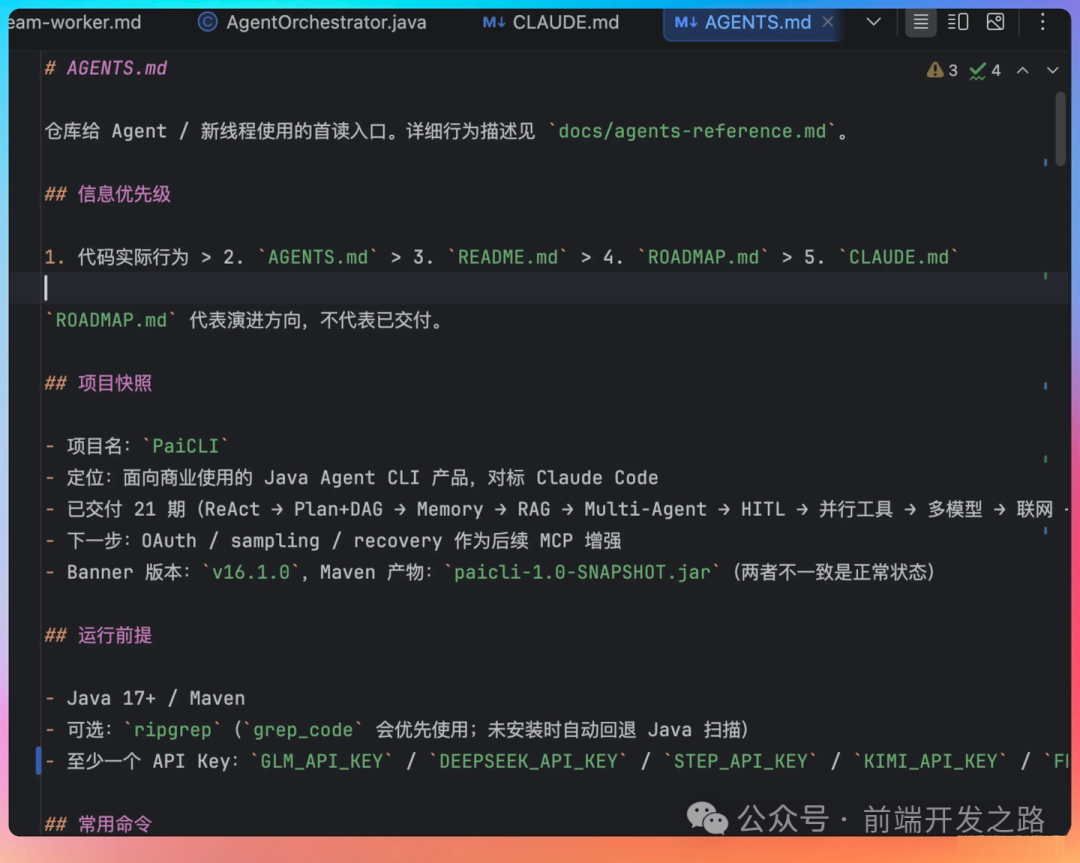
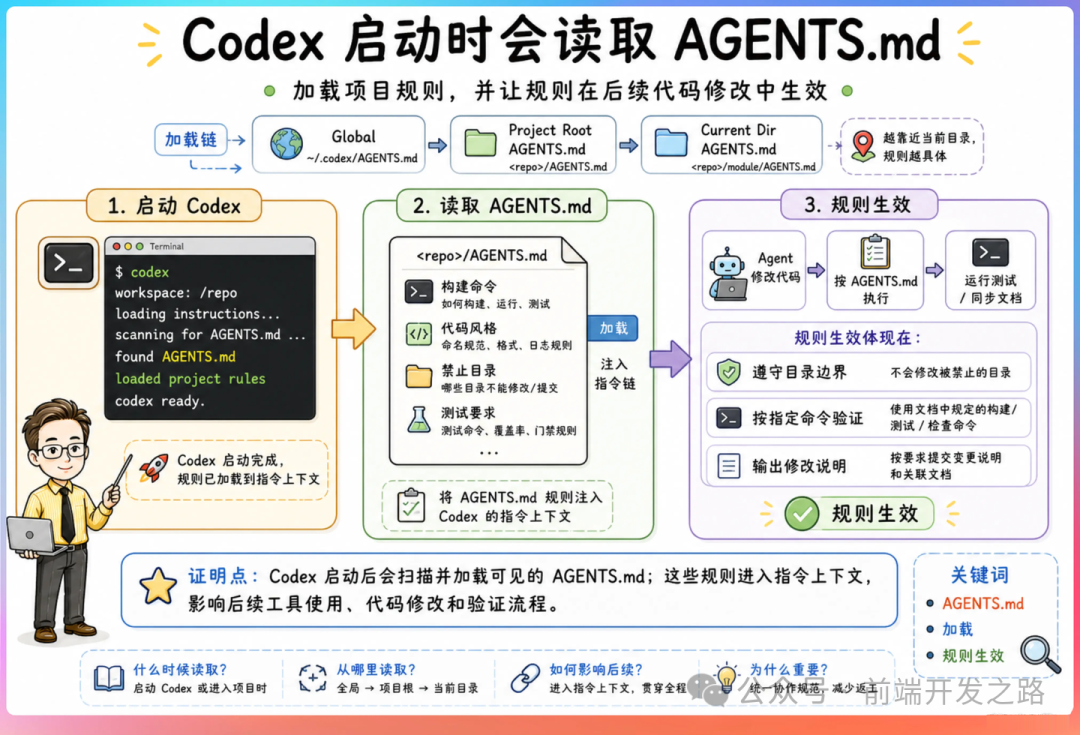
这两份文件其实是同一个东西的两套命名——Codex 认 AGENTS.md,Claude Code 认 CLAUDE.md。它们的作用相当于项目说明书,把边界讲给模型听。
AGENTS.md 要写得顶用,下面这四类信息不能少:
把架构上的约束和核心规则落进这份文件,每次开聊都自动带上,健忘这个毛病基本能压住。 凭什么? 道理很简单:模型不存长期记忆。 每开一个新会话,它都从白纸开始。AGENTS.md 充当的就是每轮对话开机自载的那块记忆芯片。你写明不许过度抽象,它就少给你造调度器;你写明测试先行,它就会先跑测试再谈提交。
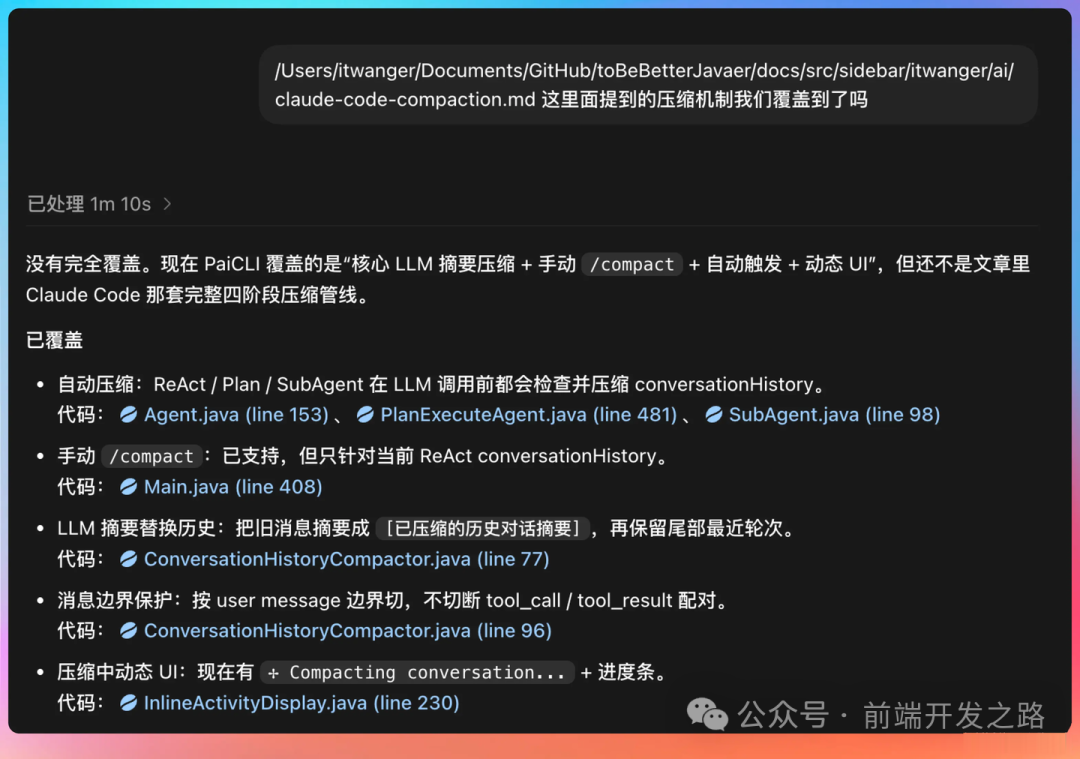
精简归精简,流程还是得写进去。比如测试与文档要先行,文档固定放 xxx 目录。 千万别写成万字长文。 这文件本身吃上下文,堆得越多越坏事。我的做法是压在 200 行以内,只留最要紧的几条。 顺便问一句:你给项目写过 rule 和 Skill 吗?发现它写歪了,你会不会让它改完顺手把规则和技能也补上? 这件事得滚动着做。 头一版不可能齐整。它每犯一次错,你就把对应的约束追加进去——坑踩过一次,第二次就该绕开。
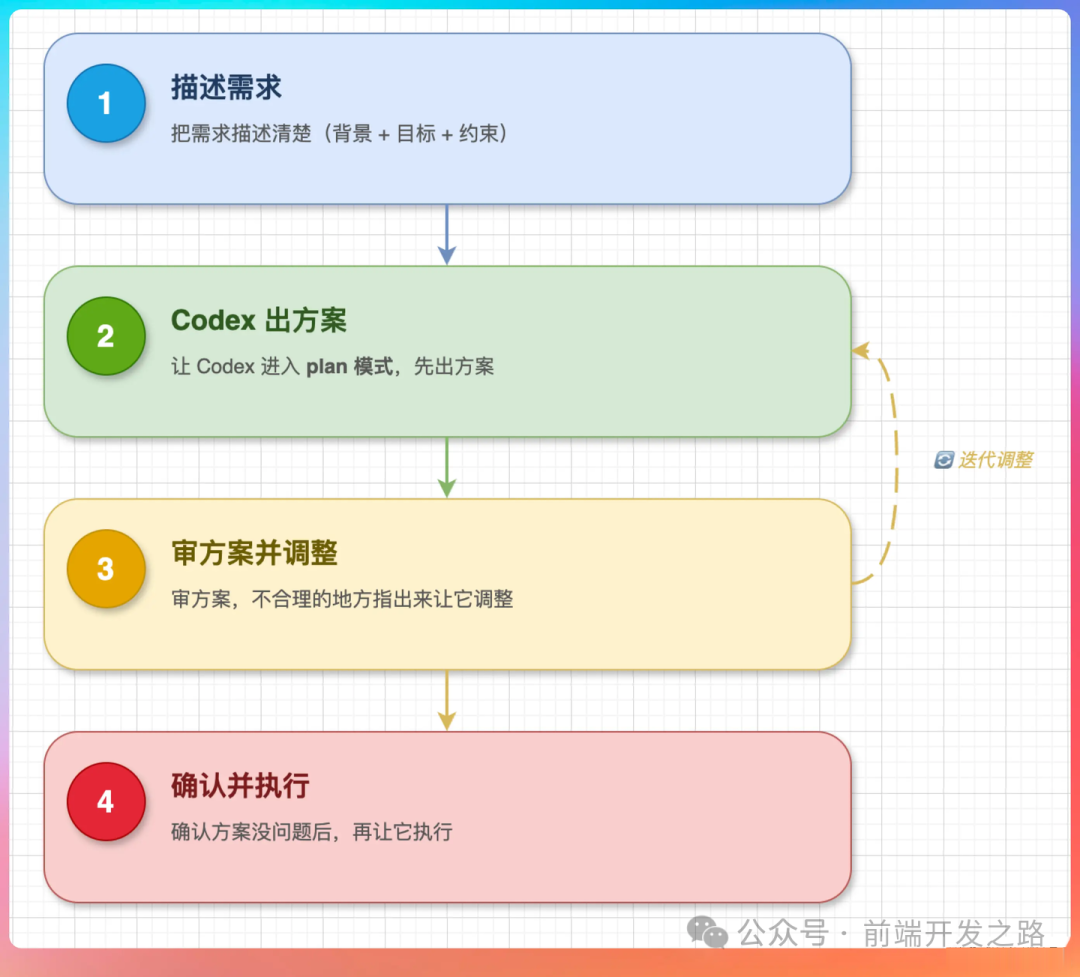
二、先让 Plan 模式把方案摆出来需求先想透,然后切进 Codex 的 plan 模式。这一步的产出极少出错,顶多在细节上再磨一磨。 可偏偏用 Codex 的人,最常漏掉的就是它。 它在 plan 模式下不动代码,只交一份执行方案:动哪几个文件、走什么路子、拆成几步。 你要做的就是把这份方案读一遍,看不顺眼的地方当场打回去重排。这比等它码完一大坨再推倒重来省事太多。
落到实操,我自己的顺序是这样:
我的建议是 这么问下来,准确率能到 99% 上下。 三、大需求切碎了喂复杂需求别整块丢,切成若干小需求,让它小步往前挪。一个原子功能收工,下一个任务就另起会话。
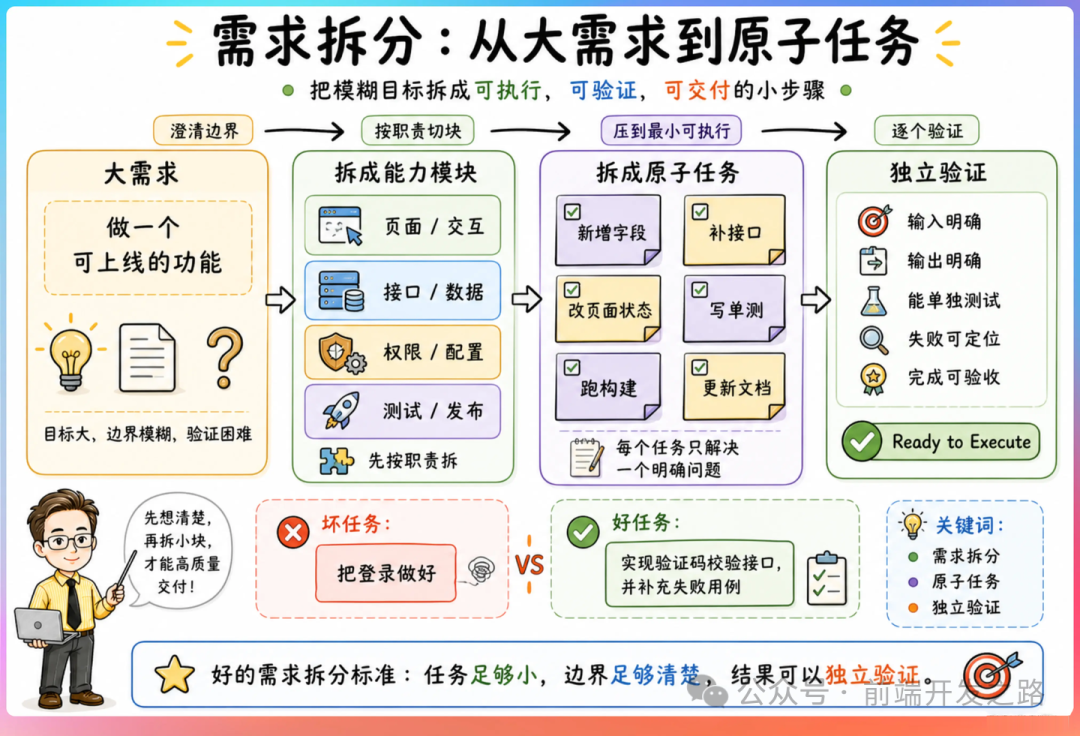
什么算原子功能? 定义是:能够单独验收的最小功能单位。举“给用户列表加搜索”这个需求,拆开来是这样:
每步各占一个对话。验完没问题,再开新窗口接下一步。
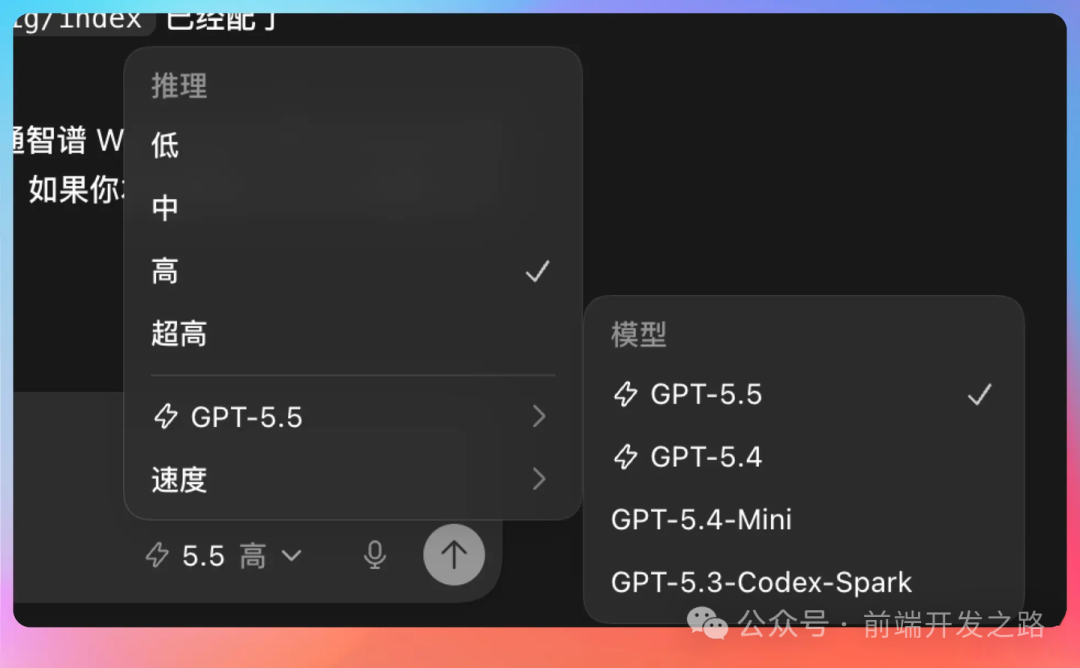
这么做有两个理由: 一来,上下文窗口有上限。一次性灌太多,注意力就被摊薄,早先立的规矩到后面就丢了。 二来,对话拖长,“记忆”会一路衰减,越往后越容易自相矛盾。一件事一个短对话,收尾就关,这是最稳的用法。 四、测试才是质量的底这一条里最要紧的,是测试。 我的习惯是交叉验:Opus 4.8 写完的交给 GPT-5.5 查,GPT-5.5 写完的交给 Opus 4.8 查。 这么过一遍,出来的代码质量会高一大截。 要是你对它写的代码心里没底,与其一行行去盯,不如丢给另一个 Agent 验。 碰到需要靠截图来验的场景,Codex 比 Claude Code 顺手。CC 传图得按 ctrl+v,而且我实测下来它有上下文长度限制,图塞多了就不行;Codex 基本没这道坎。
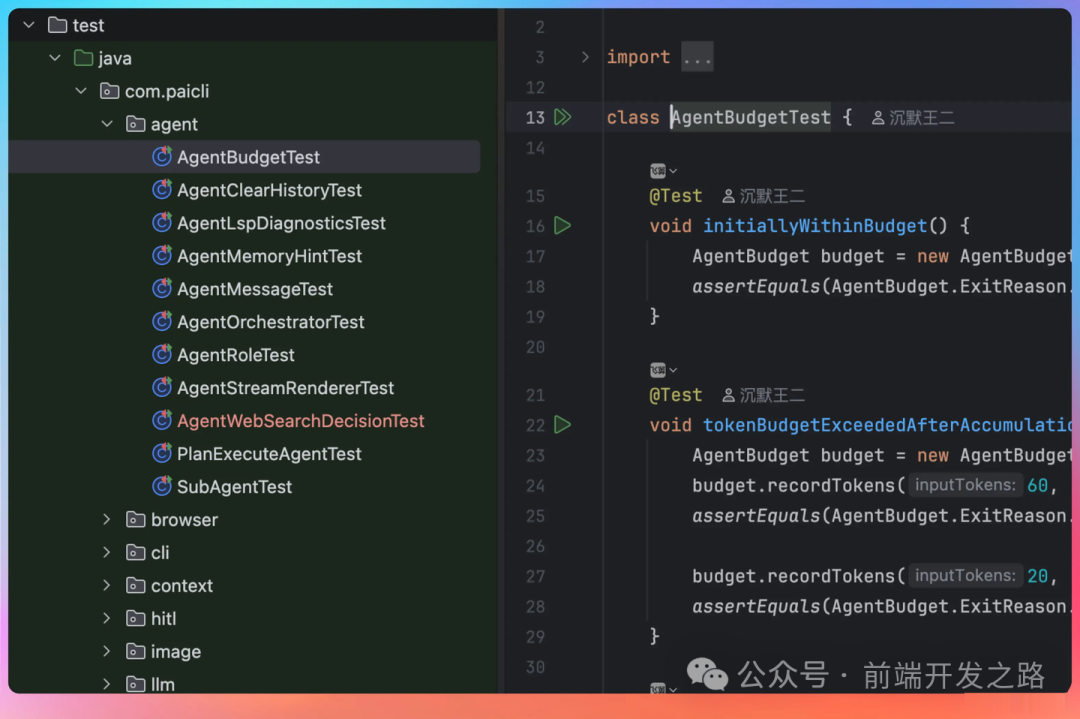
具体怎么做:
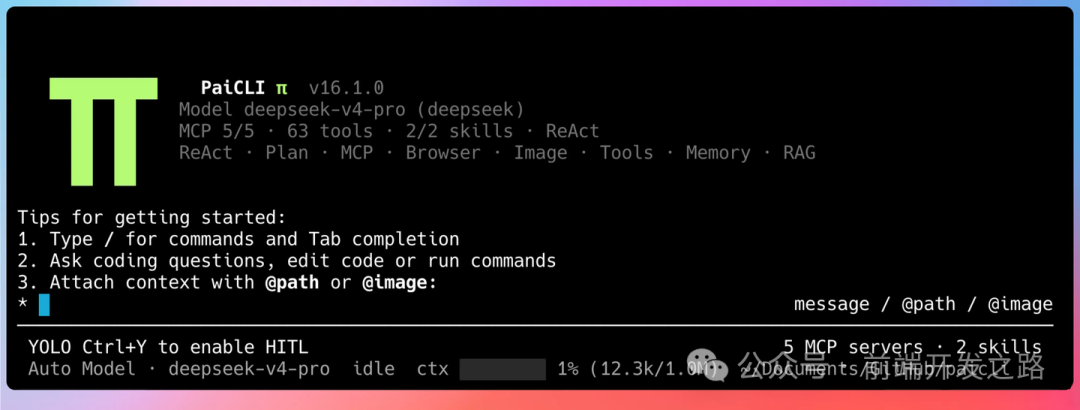
我自己那个 CLI 项目,每个功能都让 Codex 先出用例。
200 刀的额度放着也是放着,用例在手,它基本不会跑偏;万一编译挂了,它自己也会修回来。 五、别自己动手改它的代码它写的东西你别亲手去动,否则就是两个人来回拉锯的死循环。真要自己改,改完必须另开一个对话。 死循环是怎么来的? 它往后写代码时会照着上下文里现成的实现来。你偷偷动了某一段,它既不知道你改了哪里,也不知道你为什么改,下一轮很可能就把你的改动盖掉了。 该怎么做:
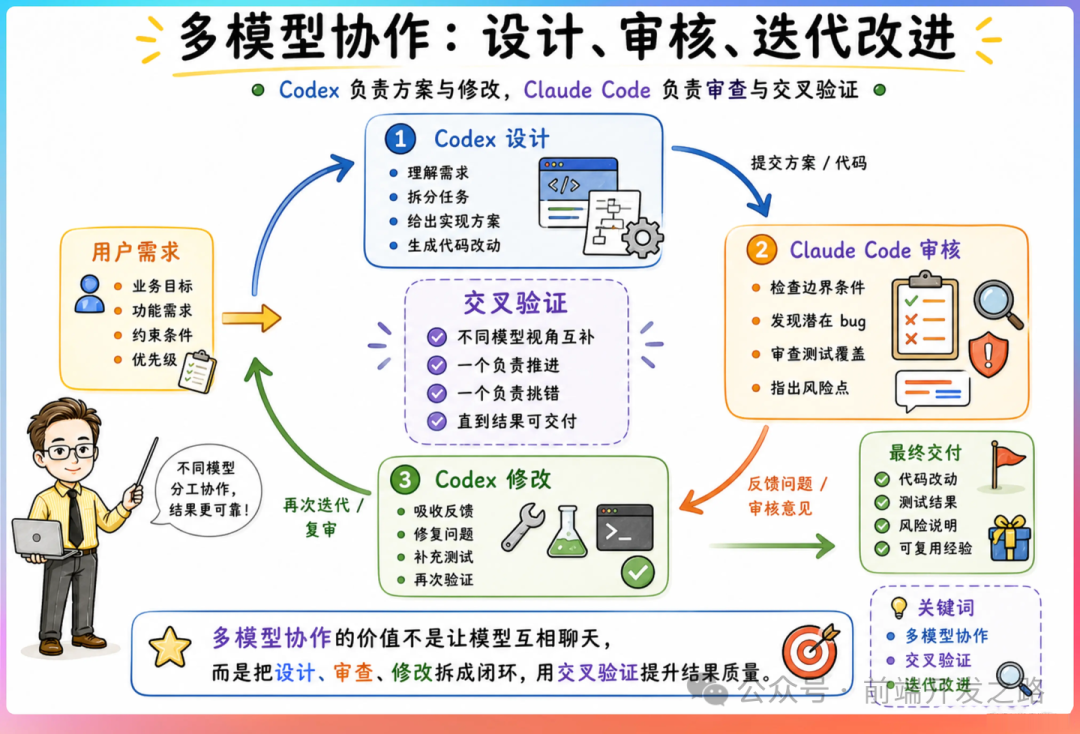
别太洁癖。就当它是多人项目里的另一个贡献者。 它交出来的东西,不可能百分之百合你的口味。 这个心态比什么技巧都重要。 AI 编程求的不是每行都漂亮,而是整体能跑、往后能维护。 六、让几个模型互相盯着隔一阵子就换个分工:Codex 出设计,Claude Code 挑毛病审一遍,再回给 Codex 评估怎么改。几个回合下来把任务清单定住,照着走就行。
说白了,这是拿不同模型的差异做交叉验证。 手上那个 CLI 项目就是按这套规矩跑的:一个功能过 Claude Code 和 Codex 几轮互查,再由 Claude Code 把需求拆开、落成一份标准的 markdown 开发计划,最后 Codex 照计划执行。
vibe coding 想做出质量,关键只有两点。
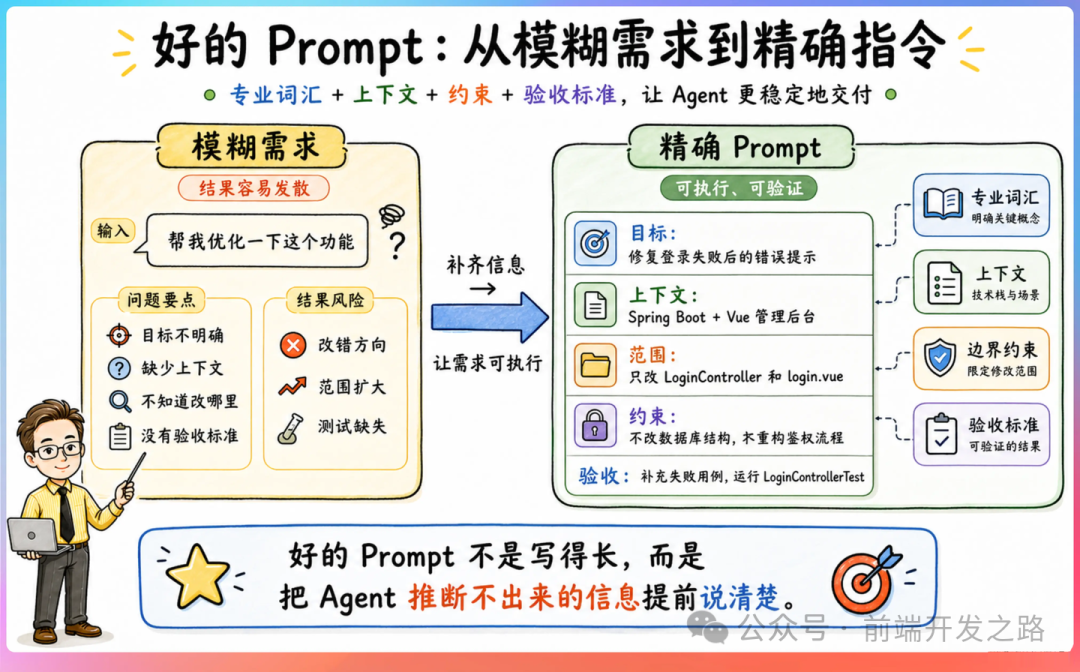
两个角色不一定非要交给两个模型。 同一个 Agent 里开两个会话就够——一个写,一个审。审核那侧不用管实现细节,只看最终的 diff 和测试结果,判断合不合理。 这条得记牢。 一旦它开始用打补丁的方式修 bug,说明架构本身已经歪了。这时候别再让它补下去,马上换另一个模型重新看架构,出重构方案。 七、Prompt 写准,别含糊措辞要用行话,“一点”“一些”“大概”这种词一个都别留。一个对话只装一个需求,多了就另开。 文档别塞太多——哪家 LLM 都有窗口上限;描述也别太省——它猜不到你脑子里想的什么。
我捋出来的 Prompt 骨架是四段:
光靠自然语言讲需求不够。
动接口就把现有定义贴进去,加字段就把表结构贴进去。模型读代码比读人话准得多。 我每做一个新功能,习惯先把官方文档翻出来,把最新版丢给 Codex,让它先吃透文档。 要不然它可能悄悄按老版本写。 训练数据自带时间戳,它天然偏好吃自己记得的那套经验。 哪怕你把 Skills 全配齐了也一样。
该出手时就得把自己攒的经验直接喂给它。 八、走官方渠道,别图便宜用中转Codex 现在的水平够用,我手上的代码基本都交给它。 原厂服务在高峰时段也可能状态下滑或者出点岔子,但总体稳,脑子在线。 中转站的坑不止是被换模型这一条,还有限流、上下文被砍、响应拖慢一连串毛病。如果你觉得 Codex 表现很差,先确认一件事:你订的是不是官方。
任务不同,模型的表现也分高下。 日常业务代码,GPT 5.5 xhigh 足够强悍;要做架构层面的设计,换 Claude Opus 更对路。 而且模型还在快速变强。 一两个月前试过觉得拉胯的,现在值得再试一次。GPT 5.5 跟半年前的 GPT 5 根本不在一个量级上。 九、架构你定,实现它写模型再强,工程上那层架构判断还是得人来。 我那个 CLI 项目做 JLine 交互的时候正好撞上这事,折腾了将近一天,交互始终不对。 最后还是自己啃官方 doc,再把设计思路一句句讲给 Codex,才算收口。
它很爱把两处业务的共性抽成一个 xxx 调度器,多数情况下这属于过度抽象。将来要改其中一边,稍不留神动了调度器,另一边就被牵连。 分工该这么切:
先让它读代码、把理解复述一遍、列出计划,然后你盯着它一点点改。
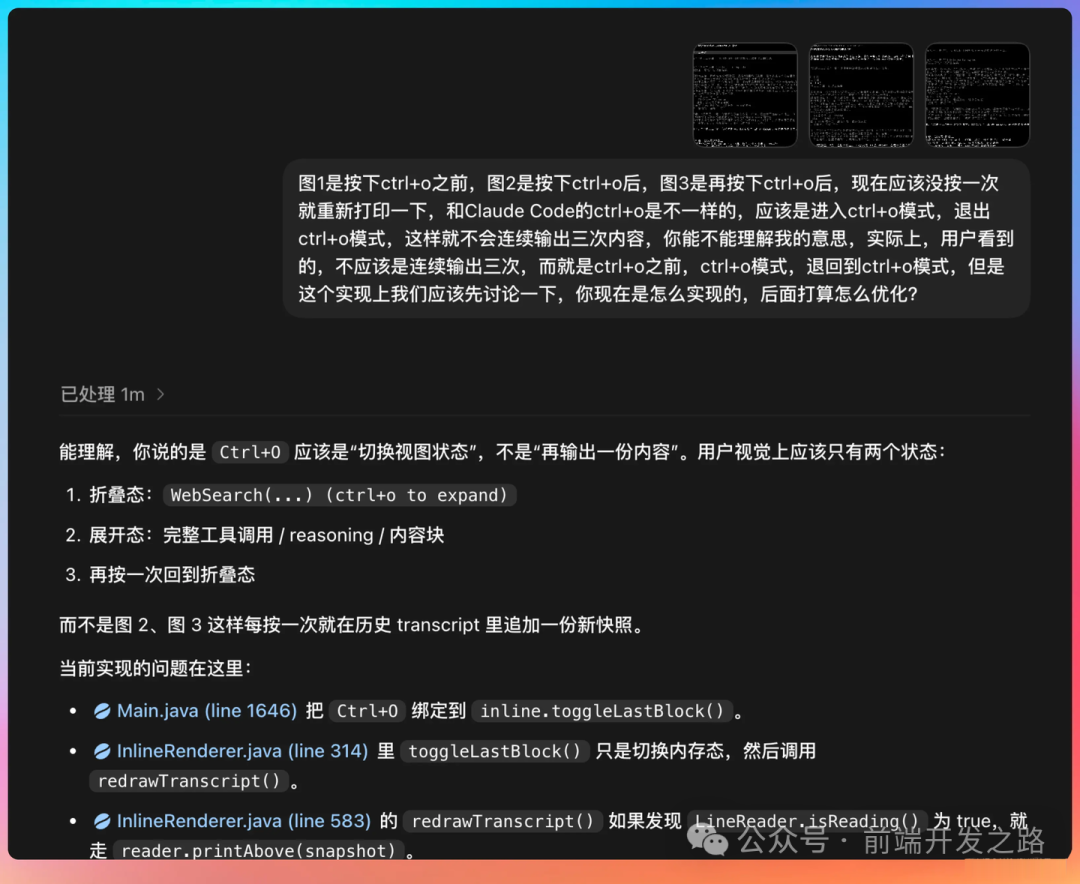
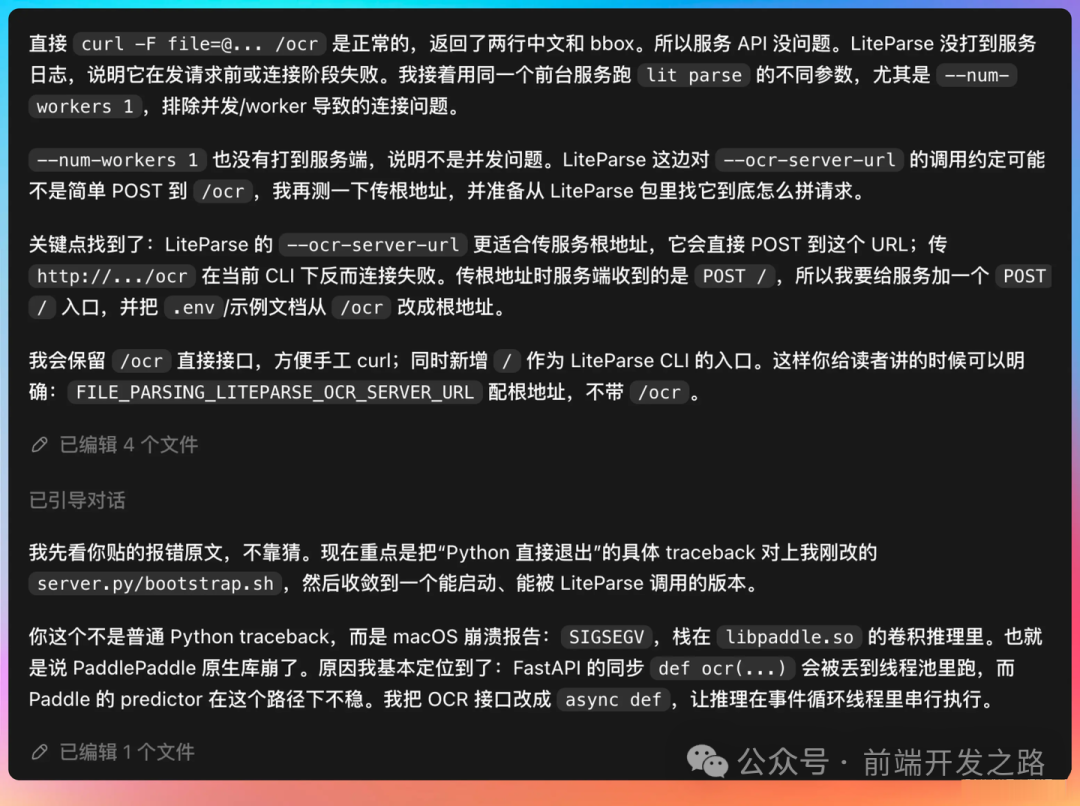
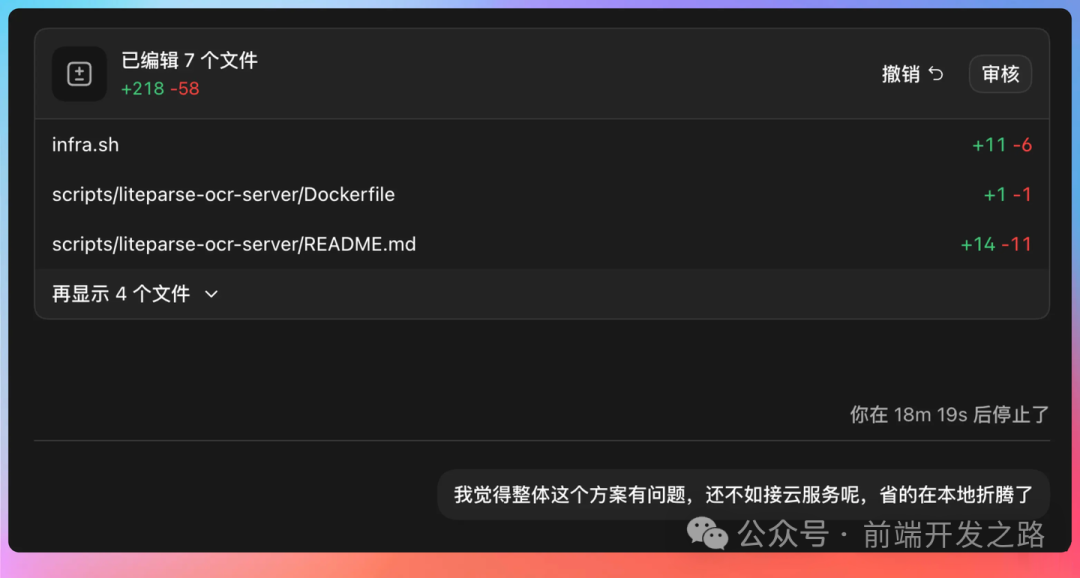
Codex 带引导能力。执行过程中一旦发现它跑偏,立刻纠回来。 该打断的时候就得打断。
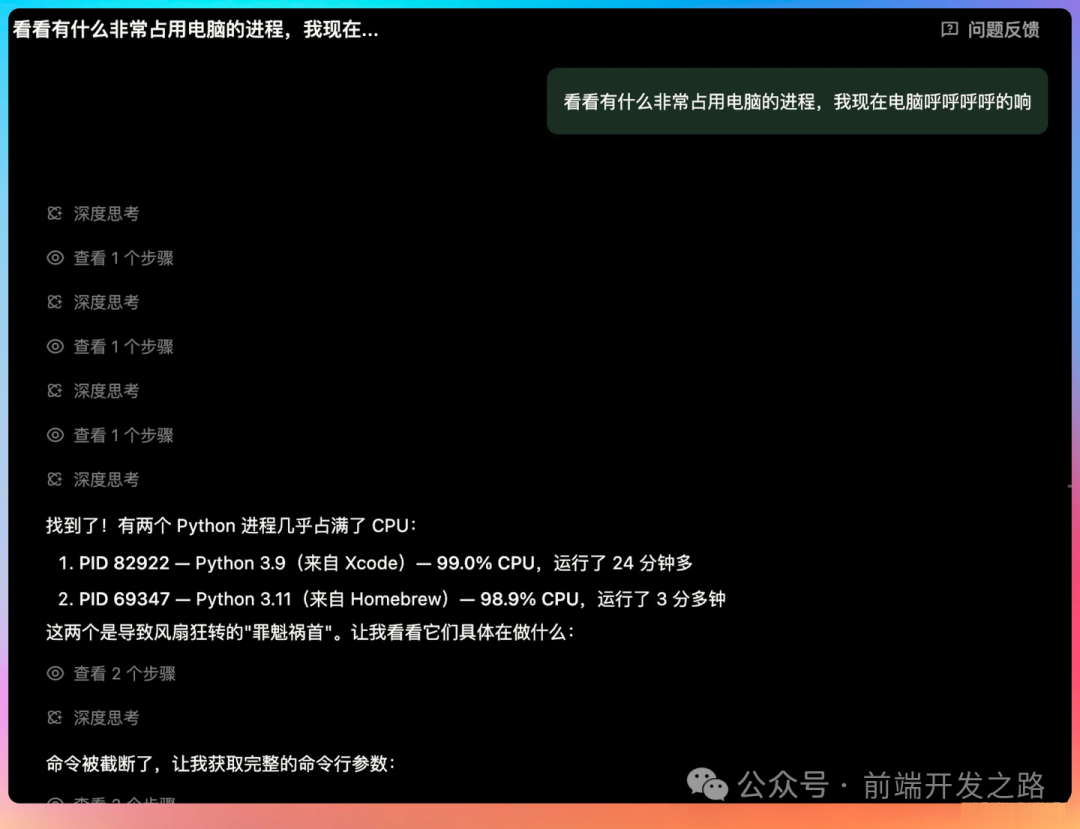
不拦着的话它真会走岔。上周对接 OCR 就碰上了,差点把 CPU 跑废。
一个 Python 进程死死吃住 99% 的 CPU,怎么都不停,风扇一路呼啸,我还当是机器配置跟不上。 现阶段它做不到完全自主。自媒体吹得再猛,离 AGI 还差得远。 人得随时插手。 最后AI 编程从来不是“把需求扔过去就撒手”。 真正用得顺的人,做的都是同一件事:把自己的工程经验一点点讲给它听。 【技术从不替人思考,它只把思考放大。】
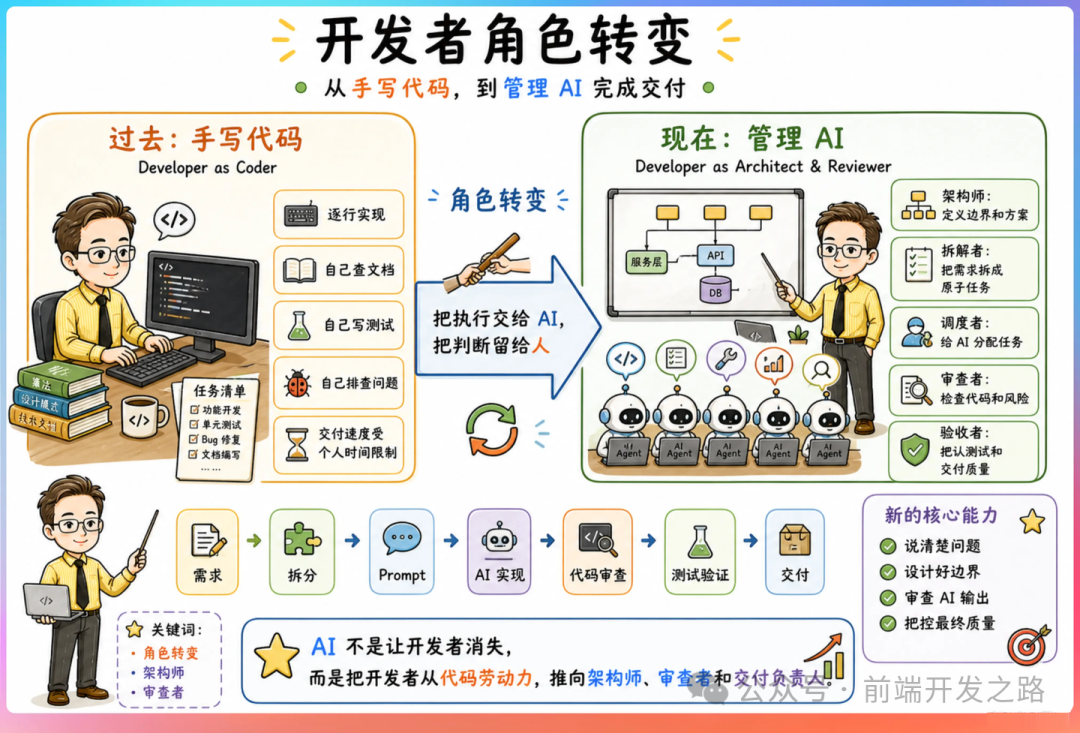
架构师还是你,拍板的还是你,最后兜底的也还是你。 差别只在于,如今你的手速借的是 AI 的手速。 卡住你的不再是敲得慢,而是没想透、没看清。 坐主位的,仍然是你。 阅读原文:原文链接 该文章在 2026/10/30 15:08:53 编辑过 |
关键字查询
相关文章
正在查询... 
|


 400 186 1886