逆向 Tabbit 浏览器:为什么做生产级 AI 浏览器,没人敢用 Electron?
当前位置:点晴教程→知识管理交流
→『 技术文档交流 』
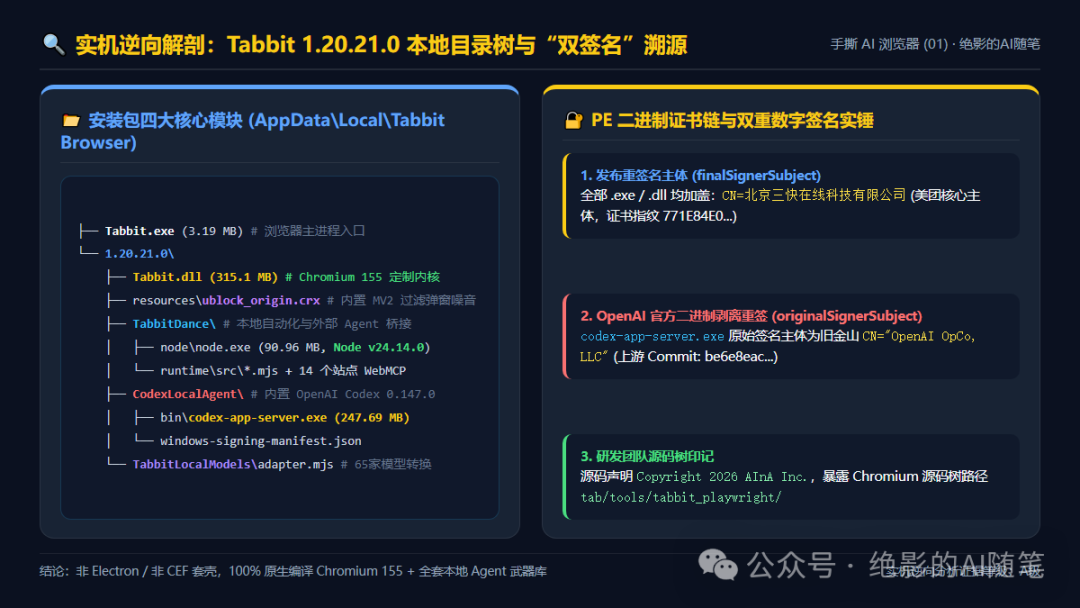
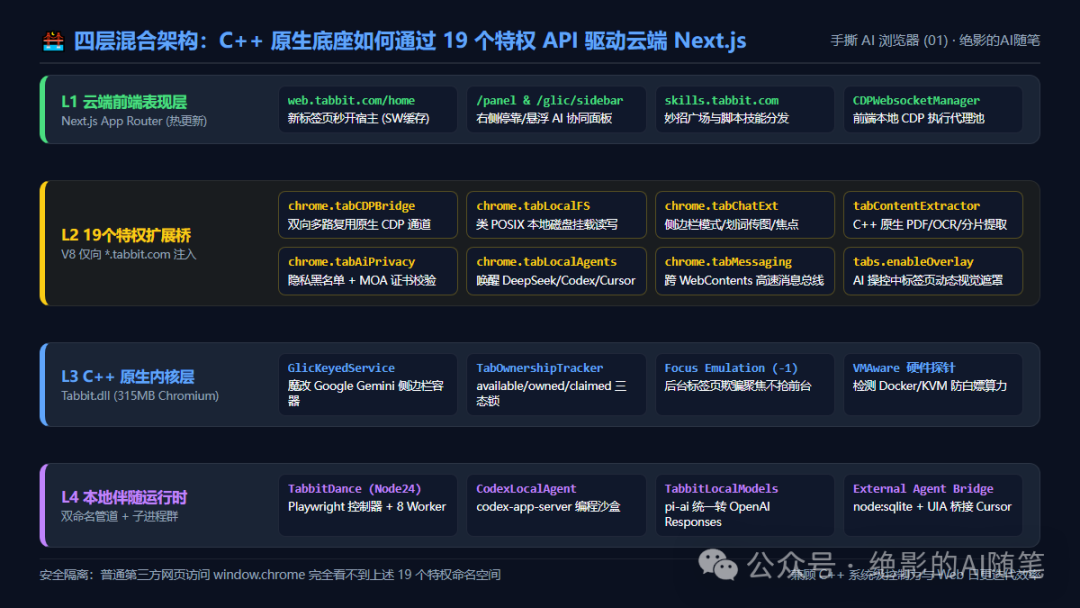
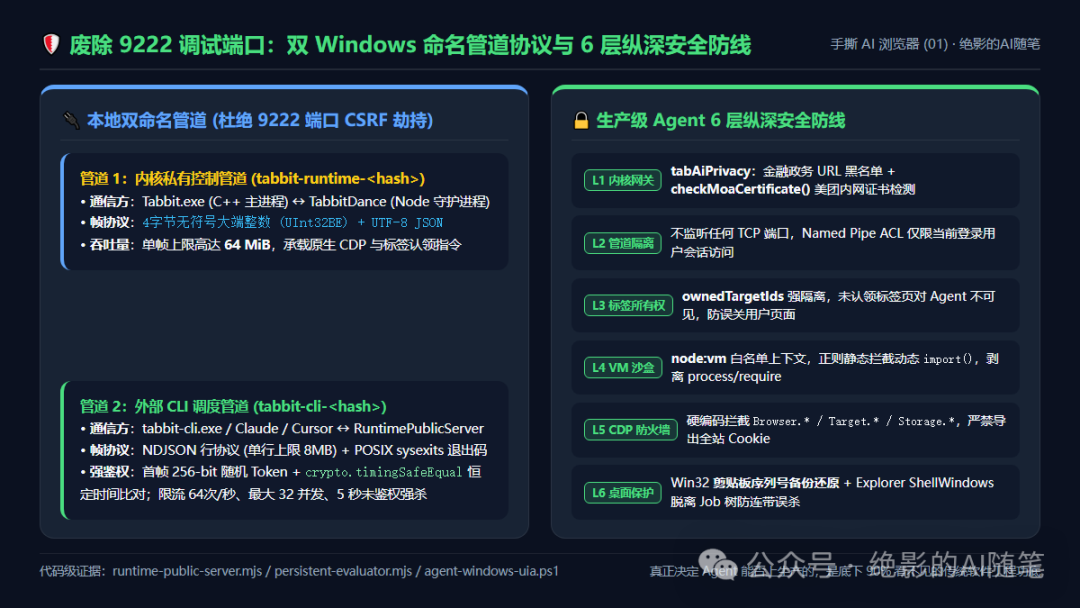
好几位同样在做 Browser Agent 和企业级 RPA 的同行私信找我聊: “市面上号称 AI 浏览器的产品我们也拆过几个,剥开来不就是 Electron 套个壳,或者干脆在原生 Chrome 里塞个 Manifest V3 侧边栏插件吗?美团这个 Tabbit,难道还能把 Chromium 源码重写一遍不成?” 说实话,在动手拆解之前,我也拿不准,目前很多大厂都用Electron做客户端,数数你的电脑里面有没有10个。(我们也用) 毕竟在大家的印象里,做探索期的新业务,最讲究“小步快跑”。拉个现成的 Electron 模板,左边放网页 直到我打开二进制分析工具,把 Tabbit 安装目录( 看着屏幕上那个体积高达 315MB 的 Tabbit.dll,以及从内存里反射出来的 19 个从未在公开文档里见过的 chrome.tab* 特权命名空间,我才意识到: 这根本不是什么套壳玩具。 今天是《手撕 AI 浏览器》连载的第 1 篇。我们不聊虚的概念,直接切开 Tabbit 的本地安装包与运行时,看看大厂正规军是怎么搭建这台机器底座的。 一、 为什么做生产级 AI 浏览器,没人敢用 Electron 套壳?在看 Tabbit 的架构之前,得先讲明白一个很多团队踩过的死胡同:为什么用“Electron 套壳”或者“写个浏览器插件”,做不出真正能干活的 AI 浏览器? 我们团队常年跟电子税务局、各大银行网银、ERP 和复杂 SaaS 后台打交道,对这两条路线的痛点深有体会: 1. Electron 套壳是“自废武功”:一旦你用 Electron 的 2. 纯浏览器插件是“戴着镣铐跳舞”:那退一步,基于原生 Chrome 写个内置扩展行不行?也不行。从 Chrome 强推 Manifest V3 之后,扩展的权限被砍得七零八落。插件既没法安静地在后台同时接管多个标签页的 CDP(Chrome DevTools Protocol)调试通道,也没法跨越复杂的同源策略去操作嵌套 想让浏览器既有原汁原味的 Chrome 兼容性(连 二、 实机验明正身:315MB 原生内核与“双签名”彩蛋打开 主程序 通过读取二进制 PE 头版本信息与运行期设备探针,它的真实底牌一清二楚: • 内核版本:直接基于极新的 Chromium 155.0.8059.40 源码分支定制编译; • 内置去广告护航:甚至在 更有趣的是我们对安装目录下所有二进制文件做数字签名溯源时的发现: ▲ 图1:Tabbit 1.20.21.0 本地四大核心模块与北京三快在线 / OpenAI 双重数字签名溯源 所有 但当我们顺着目录往下扒,进到 在这个目录底下,静静躺着一个 247.69 MB 的 codex-app-server.exe 和 57.45 MB 的 codex-code-mode-host.exe! 清单文件里明明白白地记录着:这批文件打包自 与此同时,在另一个核心目录 整个拼图瞬间完整了:这是一个由美团光年之外团队操刀、不仅重度定制了 Chromium 155 C++ 内核,还把完整的 Node.js v24 运行时与 OpenAI Codex 本地引擎全套武装到牙齿的重型工程产物。 三、 架构神来之笔:C++ 原生底座 + 云端 Next.js + 19 个特权桥看到这里,懂客户端开发的同行肯定会问一个极其现实的工程问题: “既然底层是 C++ 编译的 Chromium,那做 AI 工作台、聊天框、妙招广场这些高频变化的界面,岂不是每次改个 UI 都要重新编译几百兆的 DLL、逼用户升级客户端?” 如果真用 C++ Views 去画所有的 AI 界面,这个项目早就被研发效率拖死了。 Tabbit 在这里交出了一份堪称教科书级的混合架构答卷:「重 C++ 能力底座 + 轻云端 Next.js 工作台 + 19 个 chrome.tab* 私有扩展桥」。 当你按下 地址栏虽然显示为空白,它底层加载的其实是一个标准的云端 Next.js (App Router + React) 网页—— 重点来了: 秘密就藏在 当渲染进程创建 V8 上下文时,C++ 内核会检查当前页面的 Origin。一旦匹配受信任白名单 我在 ▲ 图2:Tabbit 四层混合架构与 19 个 chrome.tab* 特权扩展 API 核心职责 • chrome.tabCDP & chrome.tabCDPBridge:直接把底层 C++ 的 DevTools 调试通道暴露给前端网页,支持多路复用连接任意标签页或整个 Browser 实例,连 • chrome.tabLocalFS:直接在浏览器里实现了一套类 POSIX/FUSE 的文件系统挂载桥(含 • chrome.tabContentExtractor:原生 C++ 级的文档与 PDF 抽取引擎,内置 • chrome.tabChatExt & tabMessaging:精细控制右侧 AI 面板的停靠挤压(DOCKED)与悬浮(FLOATING)模式、网页划词与右键图片的秒级传递,以及跨标签页的高速消息总线; • chrome.tabs.enableOverlay:直接改了标准 Chrome 扩展 API,当 AI 正在后台操作某个标签页时,直接在原生视图层盖上一层酷炫的动态视觉遮罩。 这套设计的精妙之处在于:脏活、重活、需要突破安全沙盒的底层能力,全由 C++ 底座通过 19 个特权 API 稳稳托底;而上面纷繁复杂的 AI 交互、Prompt 编排、UI 样式,全在云端 Next.js 里随时热更新,今天改完代码,全球用户刷新一下立刻生效。 四、 双轨制 Agent 与“无端口双命名管道”通信有了这层特权桥,Tabbit 是怎么让 AI 真正动手操作网页的? 继续深扒前端 Chunk( 1. 轨道一:云端大脑 + 前端 CDPWebsocketManager 代理 当你发起一个普通的“云端任务”(比如让它在几个电商平台比价)时,负责推理规划的大模型跑在美团云端。但云端服务器显然进不了你的公司内网,也没有你本地淘宝、京东的登录 Cookie。怎么办? Tabbit 直接把你本地打开的 这里有个非常老道的工程细节:频繁挂载和卸载 CDP 调试器会导致页面状态丢失或闪烁。Tabbit 在前端做了一个带 2. 轨道二:本地 TabbitDance 守护进程 + 四通道外部协同 如果遇到复杂的长程自动化,或者你想让本机的 Claude Code、Cursor、Codex、WorkBuddy 直接接管浏览器干活,云端轨道就不够用了。这时候,随浏览器启动的本地守护进程 TabbitDance(内置 90.96MB 的 Node.js v24.14.0) 正式登场。 ▲ 图3:废除 9222 高危端口——Tabbit 双 Windows 命名管道协议与 6 层纵深安全防线 很多开源浏览器自动化工具为了省事,喜欢在启动浏览器时加个 Tabbit 彻底废除了本地 TCP 调试端口,转而设计了两条完全隔离的 Windows 命名管道(Named Pipes): ① 私有内核控制管道(\\.\pipe\tabbit-runtime-<hash>):连接 Tabbit.exe C++ 主进程与 TabbitDance 守护进程。为了极致吞吐量,它没有用文本换行,而是直接上了 4 字节无符号大端整数长度前缀(UInt32BE)+ UTF-8 JSON 负载 的二进制帧协议,单帧最大支持 64MB! ② 外部 CLI 调度管道(\\.\pipe\tabbit-cli-<hash>):对外暴露给 tabbit-cli.exe 和第三方本地 Agent。采用 NDJSON 协议,但首帧必须呈交 256-bit 的随机鉴权 Token。服务端源码( 甚至为了能直接读取你电脑上 Cursor 和 WorkBuddy 的历史对话,它直接利用 Node.js v24 原生自带的 看到这段剪贴板序列号还原代码时,我忍不住在屏幕前拍了我的玉腿:没在一线桌面自动化里被用户骂过无数次的人,绝对写不出这么细腻的防污染代码。 五、 6 层防线与内核级“反白嫖”探针把这么强的操控权交给 AI,万一 AI 发疯把网银里的钱转走了,或者把公司内网机密全传上云端怎么办? 在 1. 内核级 MOA 证书与隐私黑名单:在 2. 三态标签所有权隔离(available | owned | claimed):Agent 绝对看不到、也关不掉你正在浏览的普通标签页,只能操作自己创建或显式认领(owned)的标签页;而且 C++ 路由器还内置了保留 ID 为 -1 的后台焦点欺骗指令(Focus Emulation),让后台标签页以为自己处于聚焦状态正常渲染下拉框,却绝不抢占你前台打字的焦点; 3. VM 沙盒与 CDP 黑名单前缀拦截:Agent 执行的自动化代码跑在裁剪过的 最后再分享一个在逆向 为什么 Tabbit 敢在“无感体验模式”下,免配置直接送用户免费的 GLM-5、DeepSeek 和 Kimi 算力额度,而不怕被黑产写脚本把羊毛薅秃? 因为他们在 六、 老兵复盘:正规军的底座给我们什么启发?花大力气把 Tabbit 的 315MB 内核与进程通信拆了个底朝天,不是为了猎奇,而是为了看清生产级 Agent 产品的工程水位。 以前很多人觉得做 AI 应用就是“调调大模型接口、写写提示词”。但 Tabbit 的底座告诉我们:真正决定一款 AI 浏览器能不能上生产环境干脏活的,恰恰是那 90% 看不见的传统软件工程功底——是如何平衡原生 C++ 控制力与 Web 端热更新效率,是如何在不抢占用户焦点的前提下完成后台并发调度,是如何用命名管道和 6 层沙盒守住安全底线。 底座搭好了,接下来的问题就是:当 Agent 真正面对一个结构极其复杂、动辄几万行 DOM 的现代网页时,怎么才能不靠“截大图烧 Token”,在毫秒级内看懂页面并精准点中目标? 阅读原文:点击这里 该文章在 2026/11/18 10:33:43 编辑过 |
关键字查询
相关文章
正在查询... 
|


 400 186 1886